Mira: Lokale KI in der Schweiz neben Apertus
Mira und Apertus: wie viel KI die Schweiz lokal betreibt – mein Einzelprojekt mit Messdisziplin im Vergleich zu den grossen Schweizer Projekten.
Wenn in der Schweiz über KI-Souveränität gesprochen wird, geht es meist um das grosse Ende der Skala: nationale Sprachmodelle, Supercomputer, Hochschulkonsortien. Seit September 2025 gibt es mit Apertus ein vollständig offenes Schweizer Sprachmodell, trainiert auf dem Supercomputer «Alps» in Lugano. Am anderen Ende der Skala steht ein Projekt, das kaum jemand kennt: Mira, eine lokal betriebene KI-Assistentin: ein Arbeitsplatzrechner, kein Cloud-Modell, eine Person. Diese Person bin ich: Mira ist mein Projekt, so wie Nextfrag es im CS2-Umfeld ist.
Dieser Beitrag ordnet das Projekt ein; zuletzt nachgeführt am 29. August 2026, auf dem Stand von Version 1.36.35. Die Versionszahl ist seit Mitte August gleich; der Betrieb hat sich danach weiterbewegt. Das Erzählenswerte daran ist weniger, dass lokale KI funktioniert (das ist 2026 keine Neuigkeit mehr). Erzählenswert ist die Frage, wie ein Einzelprojekt verhindert, dass es sich selbst belügt: mit einer Messdisziplin, die selbst in der KI-Forschung selten so konsequent umgesetzt wird. Und genau dieser Kontrast macht Mira zu einem lehrreichen Gegenstück zu Apertus und den anderen Schweizer KI-Projekten.
Was Mira ist
Mira ist eine KI-Assistentin, bei der alles auf einem einzelnen Arbeitsplatzrechner läuft: Sprachmodell, Gedächtnis, Wissensarchiv und Prüflogik. Für die eigentliche Denkarbeit gibt es keinen API-Aufruf an einen externen Anbieter. Gebaut und betrieben wird das System von mir allein – mit fremdvergebener Gegenprüfung durch getrennte KI-Rollen aus verschiedenen Modellfamilien. Die ausführliche Projektbeschreibung steht auf der Projektseite zu Mira.
Die Eckwerte sind gemessen, nicht geschätzt:
- Hardware: ein Rechner mit einem Ryzen 9 9950X3D2, 64 GB RAM und zwei Grafikkarten – eine RTX 5090 für den Denker, eine RTX PRO 4000 Blackwell für den unabhängigen Prüfer. Jedes Modell ist fest an seine Karte gebunden; stimmt die Zuordnung nicht, startet das System gar nicht erst.
- Denker: Ornith-1.5-35B-A3B-BigBang-MTP, ein 35B-MoE auf der 5090, quantisiert Q4_K_M, rund 19,7 GiB. Seit 29. August 2026.
- Prüfer: Qwen3.8-27B auf der eigenen Karte, quantisiert Q4_K_M, rund 15,9 GiB. Seit 15. August 2026 – nicht mehr das frühere 3B-Modell.
Ein Rechner · lokal · keine Cloud-API
Zwei Karten, zwei Rollen
Denker
RTX 5090
rund 19,7 GiB
gemessene Dateigrösse, nicht VRAM-Snapshot
seit 29. August 2026
Prüfer
RTX PRO 4000
rund 15,9 GiB
unabhängig, eigene Karte
seit 15. August 2026
Ryzen 9 9950X3D2 · 64 GB RAM · feste GPU-Bindung · Stand 29. August 2026. Die Balken vergleichen nur die beiden Dateien, nicht die Kartenkapazität.
Das erklärte Ziel ist ausdrücklich kein selbstgehosteter ChatGPT-Klon, sondern die fähigste KI, die auf genau dieser Hardware dauerhaft laufen kann – messbar, nicht behauptet.
Das Seed-Prinzip: Denken teuer, Wissen billig
Die interessanteste Designentscheidung betrifft die Frage, wohin knappe Kapazität geht. Ein fehlender Fakt lässt sich durch ein externes Archiv ersetzen. Fehlende Denkfähigkeit nicht. Deshalb liegt Sachwissen ausserhalb des Modells, in versionierten Archiven mit vollständiger Herkunftsangabe. Das Modell soll nicht auswendig wissen, sondern wissen, wo etwas steht – und das belegen können. Wer sich mit Wissensmanagement beschäftigt, erkennt das Muster: Es ist der Unterschied zwischen einem Mitarbeiter, der alles im Kopf hat, und einem, der ein ordentliches Ablagesystem pflegt. Ersterer ist beeindruckender, letzterer ist ersetzbar, prüfbar und korrigierbar.
Eine Antwort entsteht bei Mira in acht Stufen: Klassifikation, deterministische Löser für exakt berechenbare Aufgaben, Beleg- und Gedächtnissuche vor der Antwort, Modellaufruf, Zweitprüfung durch das unabhängige Modell, deterministische Belegbindung, ein Final Gate und ein Ausgabefilter. Unsicherheit führt zu einem Vorbehalt, nicht zu einem geratenen Satz. Hart gehalten wird nur, wo Sicherheit, Offenlegung, Prozessintegrität oder eine nachweislich leere oder falsche Antwort es verlangen. Das ist das Gegenteil dessen, was die meisten Chatbots tun, und der Grund, warum das Projekt überhaupt prüfbar ist.
Die eigentliche Pointe: Messdisziplin
Lokale Sprachmodelle betreiben inzwischen viele. Was Mira von praktisch allen Hobby- und den meisten Profi-Projekten unterscheidet, ist die Evaluation. Ich habe dem Projekt ein versiegeltes Benchmark gebaut: 180 Aufgaben in 60 metamorphen Tripeln über zehn Themengruppen, mit 540 automatischen Prüforakeln. Jedes Tripel besteht aus einer Basisaufgabe, einer bedeutungserhaltenden Umformulierung (die Antwort muss identisch bleiben) und einer gezielt veränderten Variante (die Antwort muss sich ändern). So lässt sich Verstehen von blosser Mustererkennung trennen.
Dazu kommen Methoden, die man sonst aus vorregistrierten Studien kennt – wie sie im Beitrag zur empirischen Forschung beschrieben sind: Das Auswertungsverfahren inklusive Konfidenzintervallen wird festgeschrieben, bevor Daten gesichtet werden. Aufgaben, Sollantworten und Berichte sind per SHA-256 kryptografisch aneinander gebunden. Aufgabenautor und Blindlöser stammen aus verschiedenen Modellfamilien, weil zwei Instanzen desselben Modells korrelierte Fehler machen und sich gegenseitig bestätigen. Vier fertig ausgearbeitete Tripel wurden als kontaminiert erkannt und verworfen – obwohl die Arbeit schon investiert war.
Der unbequemste Teil des Projekts ist dokumentiert: wie es seine eigenen Erfolgsmeldungen zerstört, bevor es jemand anders tut. Eine Kennzahl «36 von 36 Tests bestanden» musste ich intern als Nicht-Nachweis entwerten, weil der Testlauf den produktiven Pfad gar nicht durchlief – sie darf seither nicht mehr zitiert werden. Und ein erster versiegelter Messlauf Anfang August ergab, dass meine eigene Orchestrierung schlechter abschnitt als das nackte Modell. Diesen Befund habe ich nicht relativiert, sondern zur Steuergrösse gemacht.
Wer die Beiträge hier kennt, erkennt das Muster: Es ist dieselbe Haltung wie bei Nextfrag – Messen statt Behaupten. Mehrfach hat bei Mira eine fünfminütige Messung eine gut begründete, mehrseitige Argumentation widerlegt. Meistens meine eigene.
Was sich seit Anfang August getan hat
Die auffälligste Änderung steckt im Gehäuse: Neben der RTX 5090 arbeitet eine zweite Grafikkarte, eine RTX PRO 4000 Blackwell. Hauptmodell und Prüfer kommen sich nicht mehr in die Quere; die Trennung der beiden Rollen ist physisch.
Am 15. August ist der Prüfer von einem 3B-Modell auf Qwen3.8-27B gewechselt – auf derselben zweiten Karte, unabhängig vom Denker. Am 29. August ist der Denker auf Ornith gewechselt. Der Wechsel wurde gegen den vorherigen Stand gepaart gemessen: die Punktzahl blieb gleich, die Laufzeit der 120er-Welle sank von 3,2 auf 2,4 Stunden.
Version 1.36.35 · Zahl gleich · Stack nicht
Drei Daten, ein Label
Produktlabel 1.36.35 bleibt stehen
13. August
Label 1.36.35
seitdem nicht angehoben
15. August
Prüfer 27B
statt des früheren 3B
29. August
Denker Ornith
score-neutral, kürzere Welle
Produktiv, geprüft am 29. August 2026
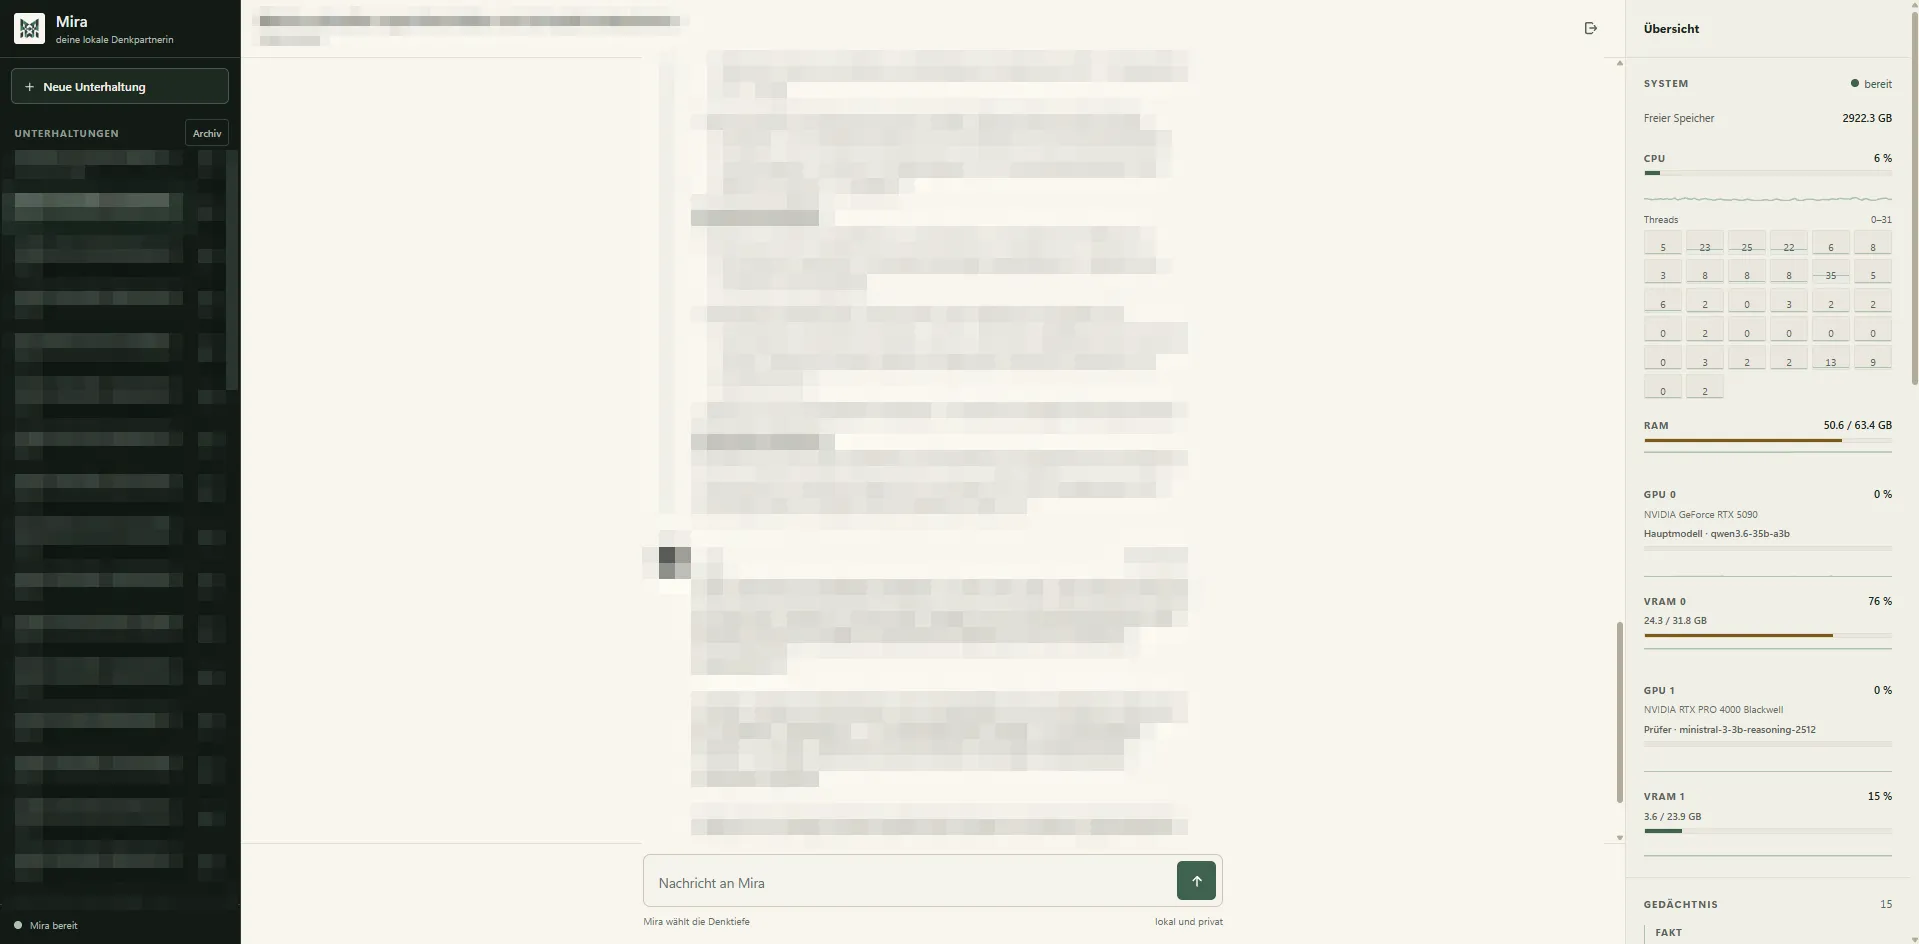
Die Aufnahme zeigt die Oberfläche und die Hardware-Rollenteilung. Konversation bleibt verpixelt: Aufgabentexte aus dem Messbetrieb dürfen nicht öffentlich werden. Die Modellnamen und die RAM-Zahl in diesem Bild sind ein älterer Zeitpunkt, der aktuelle Stack steht oben.
Der Rest des Monats war Betriebs- und Vertrauensarbeit, keine Featureliste:
- Ein überwachter Prozessbaum. Die Anwendung, beide Modellprozesse und der Zugang laufen unter einem Betriebs-Supervisor: kontrolliertes Starten und Stoppen, und fremde Prozesse werden nie übernommen.
- Ein GUI, das Arbeit zeigt statt Illusion. Während Mira arbeitet, sind die Arbeitsschritte sichtbar; danach erscheint die geprüfte Antwort. Bewusst kein Token-Streaming: Sichtbar wird nur, was die Prüfkette passiert hat. Screenreader-tauglich ist es auch.
- Ein enges Austauschfach für Dateien. Dateiaustausch nur in einem eng begrenzten lokalen Ordner, nur für die Entwicklerrolle, und es können ausschliesslich neue Dateien angelegt werden. Die Chatrolle bleibt komplett ausgeschlossen.
- Ein kanonisches Selbstmodell. Eine einzige strukturierte Quelle speist Systemprompt, Identitätsprüfung und Selbstauskunft. Sie trennt den gerade antwortenden Prozess von der gespeicherten Historie – und behauptet weder Bewusstsein noch Gefühle noch Fehlerfreiheit.
- Ein Live-Systemmonitor für CPU, RAM und GPU im Entwickler-GUI – gemessen mit rund 0,05 Prozent eines CPU-Kerns, ohne dass dabei Daten gespeichert werden.
- Härtere Vertrauensgrenzen. Nutzertext bleibt zitierbar, gilt aber nie als vertrauenswürdige Quelle für die Antwortprüfung. Und die Oberfläche zeigt Modelle nur auf der Grafikkarte an, auf der sie nachweislich laufen.
- Ein Rückbau. Ein Sampling-Parameter (DRY), der zwischenzeitlich global verbreitert worden war, ist auf seinen alten, engen Geltungsbereich zurückgesetzt.
Der Grund für den Rückbau war der ehrlichste Befund Anfang August: Eine dreifache Regressionsmessung auf 120 festen Aufgaben deckte eine Qualitätsregression der damaligen Version auf: Viele Antworten scheiterten an Formatblockaden. Die Ursache habe ich systematisch eingegrenzt; der Hauptverdächtige war genau jener verbreiterte Sampling-Parameter. Danach wurde erneut gemessen. Eine Regression zu finden ist der Zweck des Messsystems, nicht sein Versagen.
Gemessen · nicht behauptet
Orchestrierung gegen das nackte Modell
1. August 2026
nacktes Modell
darunter
erster versiegelter Vergleich
Historie, keine Gegenwart
Ende August 2026
nacktes Modell
darüber
Δ +0,156 [0,083; 0,228]
120 Aufgaben · dreimal · gepaart
gegen nacktes Ornith
Der Modellwechsel auf Ornith blieb score-neutral; die Welle wurde kürzer (2,4 statt 3,2 Stunden). Die Markierungen zeigen nur die Richtung, keine Skala der Punktzahl.
Wie es weitergeht
Der ursprüngliche Fahrplan war eine feste Kette von Meilensteinen. Inzwischen ist er auslöserbasiert: Was als Nächstes kommt, entscheidet das Ergebnis der letzten Messung, nicht ein Plan von gestern. Der damalige Qualitäts-Screen ist gelaufen. Eine versiegelte Folgewelle kündige ich nicht an.
Als Nächstes steht eine weitere Messung auf dem bestehenden Lineal, nachdem der Denker gewechselt hat. Eine Variable pro Messakt. Kein Urteil aus einem Einzellauf – für Wirkungsaussagen braucht es mindestens drei Wiederholungen. Lernen nur hinter vier Toren: Snapshot vorher, protokolliertes Ereignis, automatisches Erfolgsmass mit Rückrollung, und Fremdinhalte bleiben Daten. Sicherheitsgrenzen und das Messsystem selbst ändert nur der Mensch.
Was diesen Takt begrenzt, ist selten die Idee und oft die Hardware. Die Preise für Grafikkarten und Arbeitsspeicher haben 2026 deutlich angezogen, und Mira ist bis heute vollständig privat finanziert. Das hat eine disziplinierende Seite: keine Anschaffung ohne den Messwert, der sie begründet. Als Nächstes an der Hardware steht mehr Arbeitsspeicher, von 64 auf 128 GB. Eingebaut ist das noch nicht.
Apertus: das nationale Gegenstück
Apertus beantwortet dieselbe Grundfrage – wie viel KI geht ohne Abhängigkeit von US-Clouds? – auf einer völlig anderen Ebene. Das Modell wurde von der EPFL, der ETH Zürich und dem Supercomputing-Zentrum CSCS im Rahmen der Swiss AI Initiative entwickelt und im September 2025 veröffentlicht: trainiert auf 15 Billionen Token in über 1’000 Sprachen, darunter Schweizerdeutsch und Rätoromanisch, in zwei Grössen mit 8 und 70 Milliarden Parametern. Der entscheidende Punkt ist die vollständige Offenheit – nicht nur die Gewichte, sondern auch Trainingsdaten und Trainingsrezept sind dokumentiert und frei zugänglich. Das unterscheidet Apertus von fast allen «offenen» Modellen der grossen Anbieter, bei denen die Daten Betriebsgeheimnis bleiben.
Seither hat sich einiges bewegt: Swisscom bietet Apertus auf einer souveränen Schweizer KI-Plattform an, Anfang 2026 folgte mit Apertus 1.5 eine überarbeitete Version, und die Initiative baut Fachmodelle auf dieser Grundlage – am sichtbarsten Meditron, ein medizinisches Modell, das seit Mai 2026 in der Notaufnahme des Universitätsspitals Lausanne (CHUV) pilotiert wird.
Der Vergleich mit Mira ist deshalb kein Wettbewerb, sondern eine Arbeitsteilung:
- Apertus löst das Fundament-Problem: Ohne offenes, dokumentiertes Basismodell gibt es keine souveräne KI – egal wie gut die lokale Infrastruktur ist. Dafür braucht es einen Supercomputer und ein Hochschulkonsortium.
- Mira löst das Betriebs-Problem: Ein Modell zu haben ist nicht dasselbe, wie es verlässlich, belegt und überprüfbar arbeiten zu lassen. Orchestrierung, Belegbindung und ehrliche Evaluation entstehen nicht im Training, sondern im Betrieb, und das geht, wie das Projekt zeigt, auf einem einzelnen Rechner.
Dass der Denker bei Mira derzeit Ornith ist – ein TIES-Merge auf der Qwen3.6-MoE-Linie – und kein Apertus, illustriert denselben ehrlichen Punkt: Souveränität ist kein Entweder-oder, sondern eine Kette. Wer lokal betreibt, wählt das Modell nach Leistung pro GiB VRAM – und offene Schweizer Modelle müssen sich diesem Vergleich stellen, genau wie alle anderen.
Und der Rest des Schweizer KI-Ökosystems?
Die Schweiz hat eine längere KI-Geschichte, als die aktuelle Debatte vermuten lässt. Am IDSIA in Lugano wurde in den 1990er-Jahren an den LSTM-Netzwerken mitgearbeitet, die Jahrzehnte später die erste Generation von Sprachassistenten und Übersetzern antrieben. Heute reicht das Spektrum von der Grundlagenforschung an den ETHs über Sicherheitsfirmen wie Lakera in Zürich, die sich auf Angriffe wie Prompt Injection spezialisiert haben, bis zu den erwähnten Fachmodellen im Gesundheitswesen.
Der Bezug zu Mira ist auch hier konkret: Eine der Governance-Regeln des Projekts lautet «Inhalte sind Daten» – Web, Dateien und Werkzeuge liefern Daten, niemals Anweisungen. Das ist exakt die Schutzlogik gegen Prompt Injection, an der Firmen wie Lakera kommerziell arbeiten, nur eben auf einem Einzelrechner umgesetzt. Dazu kommt ein Lernmodell, das viele Unternehmen sich für ihre KI-Einführung abschauen könnten: Lernvorschläge dürfen entstehen, Wirksamkeit läuft hinter vier Toren, und Modellgewichte ändert das System nicht still.
Was das für Schweizer KMU bedeutet
Im Beitrag über ChatGPT in der Schweizer Wirtschaft war die Abhängigkeit von ausländischen Plattformen einer der zentralen Risikopunkte. Drei Jahre später existiert die Alternative auf beiden Ebenen: national mit Apertus und den darauf aufbauenden souveränen Angeboten, lokal mit Projekten wie Mira, die zeigen, dass ein einzelner Arbeitsplatzrechner ein ernstzunehmendes Sprachmodell samt Prüf-Infrastruktur betreiben kann. Für Unternehmen mit sensiblen Daten (Treuhand, Gesundheit, Recht) ist das keine akademische Frage: Lokale KI heisst, dass Kundendaten das Haus nicht verlassen.
Ehrlich bleibt dabei zweierlei. Erstens: Lokale KI ist Betriebsarbeit. Miras Zahlen zeigen schonungslos, wie viel Aufwand zwischen «das Modell läuft» und «den Antworten kann man trauen» liegt – über 1’000 Regressionstests, zwei unabhängig implementierte Prüfprogramme, die zu identischen Hashes kommen müssen, 25 abgewiesene Manipulationsversuche am Prüfwerk. Zweitens: Die Frage, welche Arbeit KI übernimmt und welche beim Menschen bleibt, verschiebt sich damit erneut. Wer heute beurteilen kann, ob eine KI-Antwort belegt ist oder nur plausibel klingt, hat eine Fähigkeit, die wertvoller wird, nicht billiger.
Fazit: Souveränität hat zwei Enden
Apertus zeigt, dass die Schweiz ein offenes Basismodell bauen kann, das internationalen Vergleichen standhält. Mira zeigt, dass eine einzelne Person auf einem einzelnen Rechner einen KI-Betrieb aufbauen kann, dessen Evaluationsstandards (Vorregistrierung, Doppelblind-Aufbau, Kontaminationsprüfung, kryptografische Beweiskette) strenger sind als das, was viele kommerzielle Anbieter ihren Kunden zeigen. Das eine braucht einen Supercomputer, das andere Disziplin.
Für die Schweizer KI-Debatte sind beide Enden nötig. Modelle ohne überprüfbaren Betrieb sind Infrastruktur ohne Nutzen; Betrieb ohne offene Modelle bleibt abhängig. Und für alle, die KI im eigenen Unternehmen einführen, ist die übertragbare Lektion aus beiden Projekten dieselbe: Nicht die Demo zählt, sondern die Messung, und eine gute Messung ist eine, die auch das eigene Lieblingsergebnis zerstören darf.